
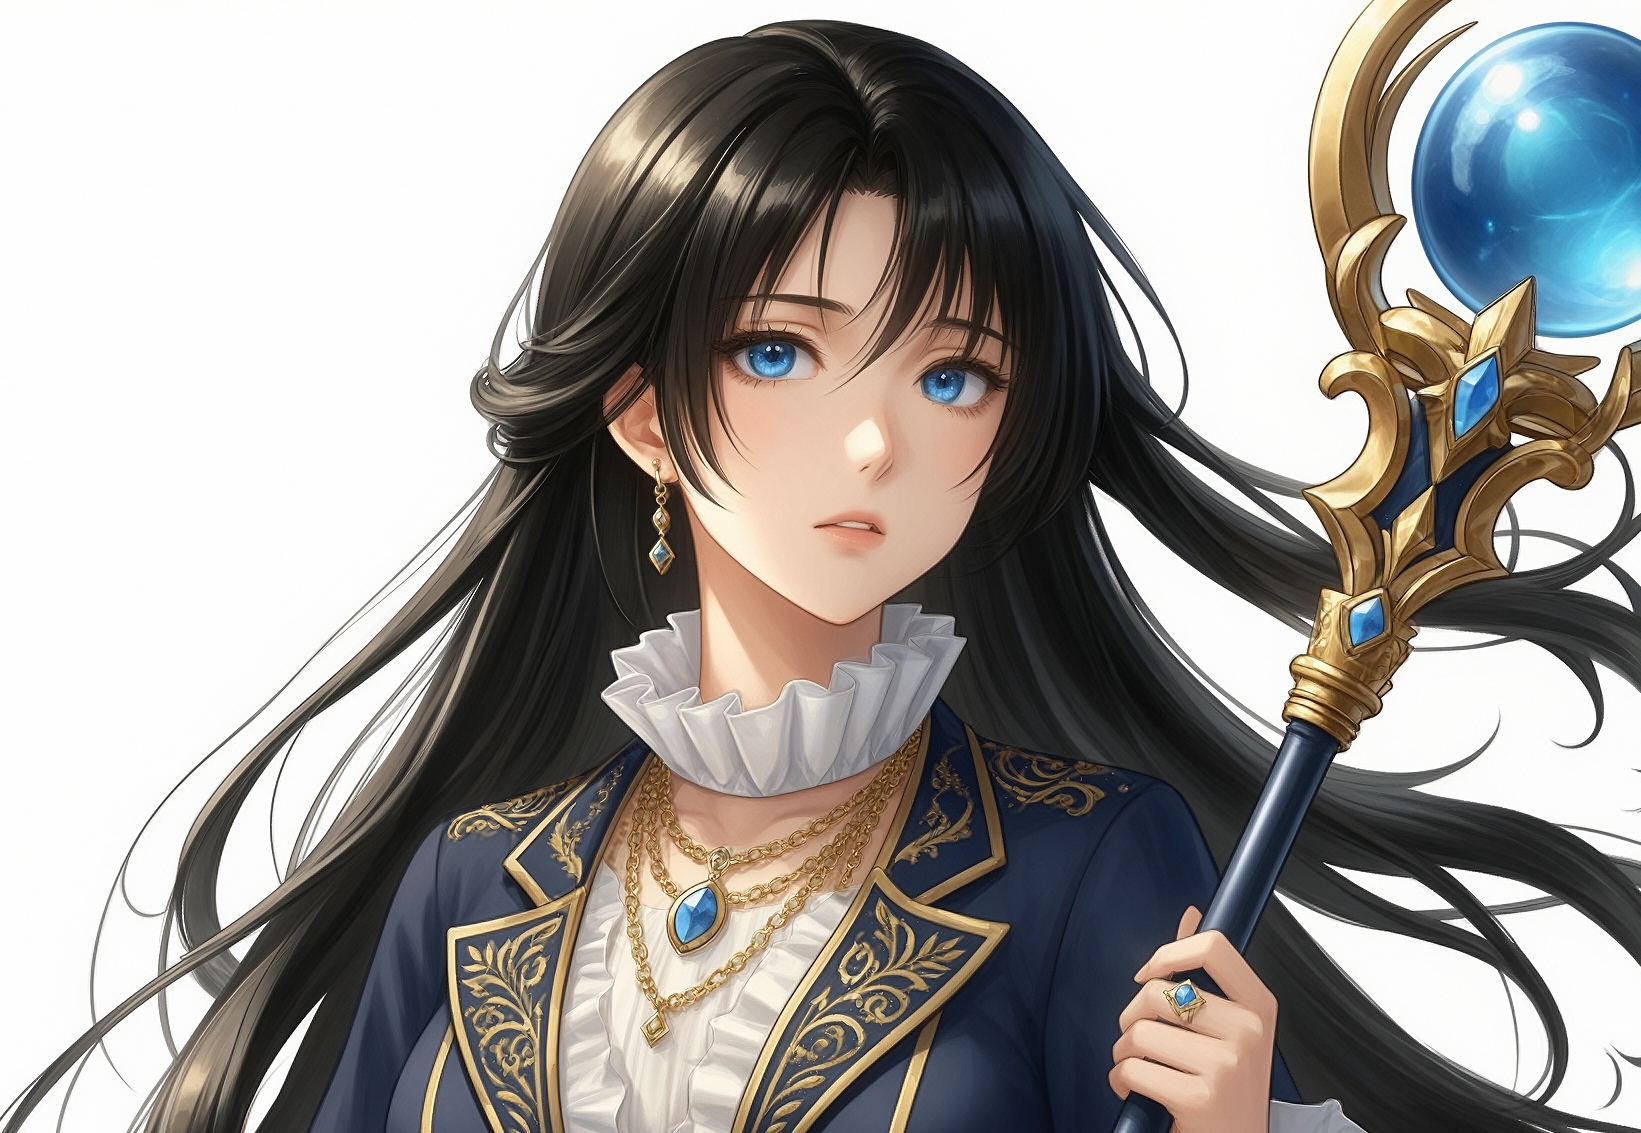
Local AI – ComfyUIを使用したKarenの画像
「紅の残響」(英語名:Resilient Echoes-The Epic of the Spring Weaver)の自主アニメ化を目指して、プロモーションビデオ作製のために、Local AIを勉強中(半ば忘備録)
ハードウエア環境、GPU: Nvidia GeForce RTX 5060ti VRAM 16GB
日本語の発音はまだAIでは難しそうなので、まずは、英訳時に使用した「Translation Bible」を基に英語版で作成し、日本語字幕を付ける予定です。
第一段階として、キャラクター(Karen)のイメージの固定を行っています。
ComfyUI上での手順は、「Apply InstantID」にKarenの顔アップ画像(挿絵のためにChatGPTで作成したもの)を「Batch image」で複数読み込んで、イメージを抽出し「KSampler」に渡して画像化するというものです。
基本的な接続:「Load Checkpoint」→「Apply InstantID」→「Apply ControlNet(ポーズ用)」→「Apply ControlNet(ラインアート用)」→「KSampler」→「VAE Decode」→「FaceDetailer(顔用)」→「FaceDetailer(手用)」→「Save Image」
二つの「Apply ControlNet」には、それぞれ、「Set Union ControlNet(Openpose)」と「Set Union ControlNet(Lineart)」を接続しています。
「CLIP Text Encode (Prompt)」をPositive用とNegative用二つ、「Apply InstantID」と「FaceDetailer」に接続することで、顔や画角などの指示をしています。
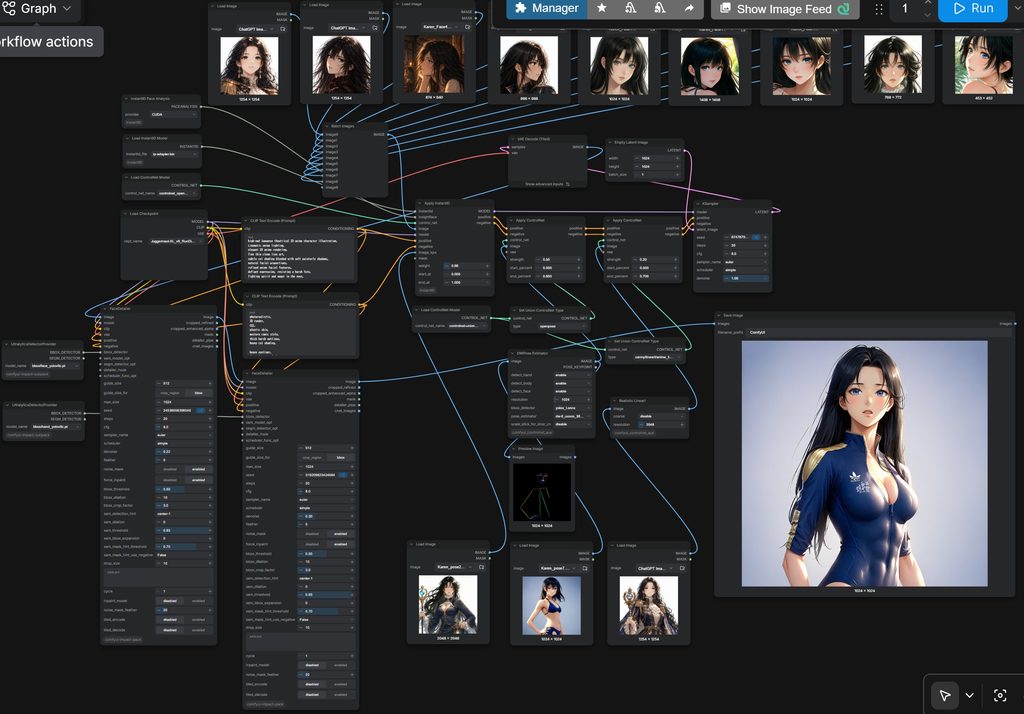
ワークフローはこんな感じ。「Apply InstantID」にも画角参照用のポーズ画像を入れています。ポーズ用の画像は出力画像に合わせて全て正方形にする必要があります。
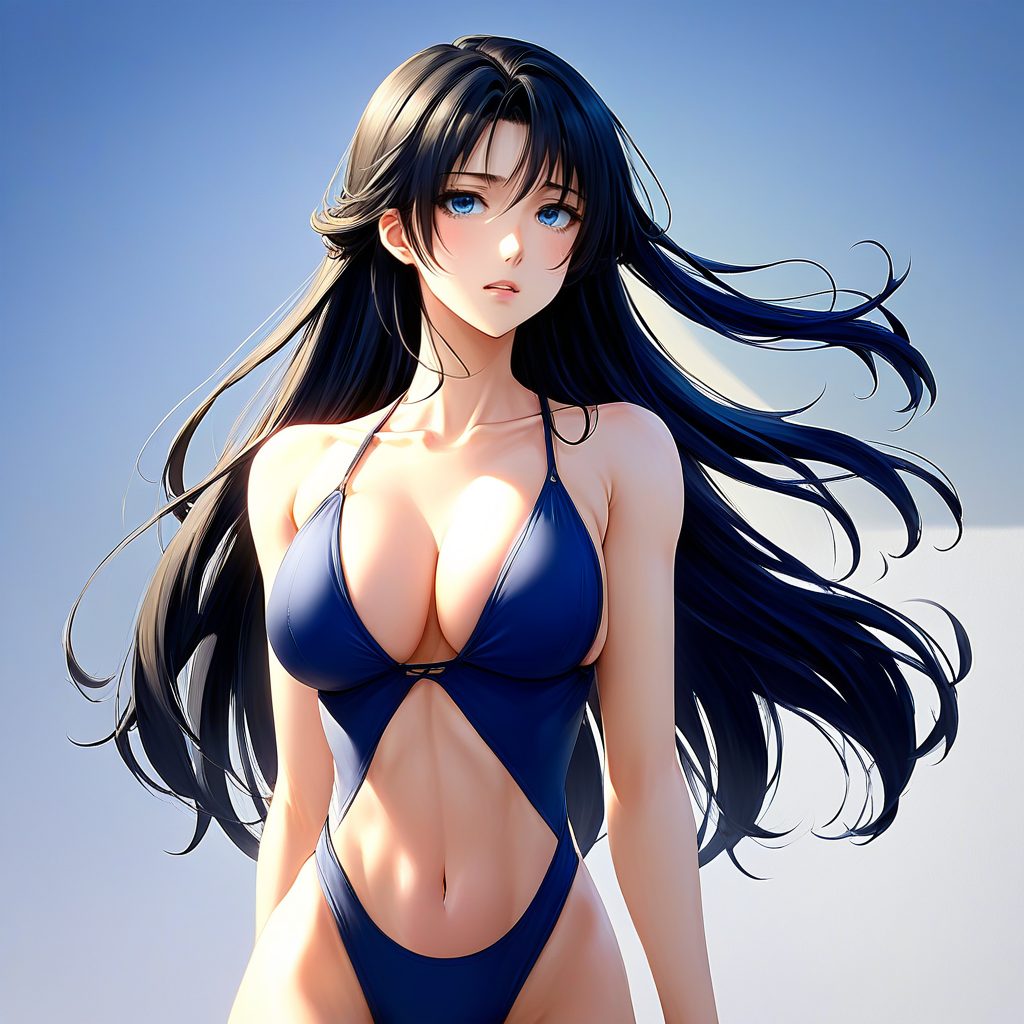
衣装は後で指定するため、後の処理でAIが体のラインを判別しやすいように水着にして背景を無地にしています。
この画像を、ComfyUIのテンプレートの中に入っていた「FireRed-Image-Edit-1.1-transformer」のワークフローで軽く(Strength_model:0.2, Steps: 1)処理すると同時に衣装、アクセサリー等を変更します。これで、Karenの画像が同じイメージを保ったまま、ポーズ、衣装、背景を変更して量産可能になります。今回は、元絵に既存のChatGPT画像を使用しましたが、自分で描いたラフなスケッチでも同じことができそうです。
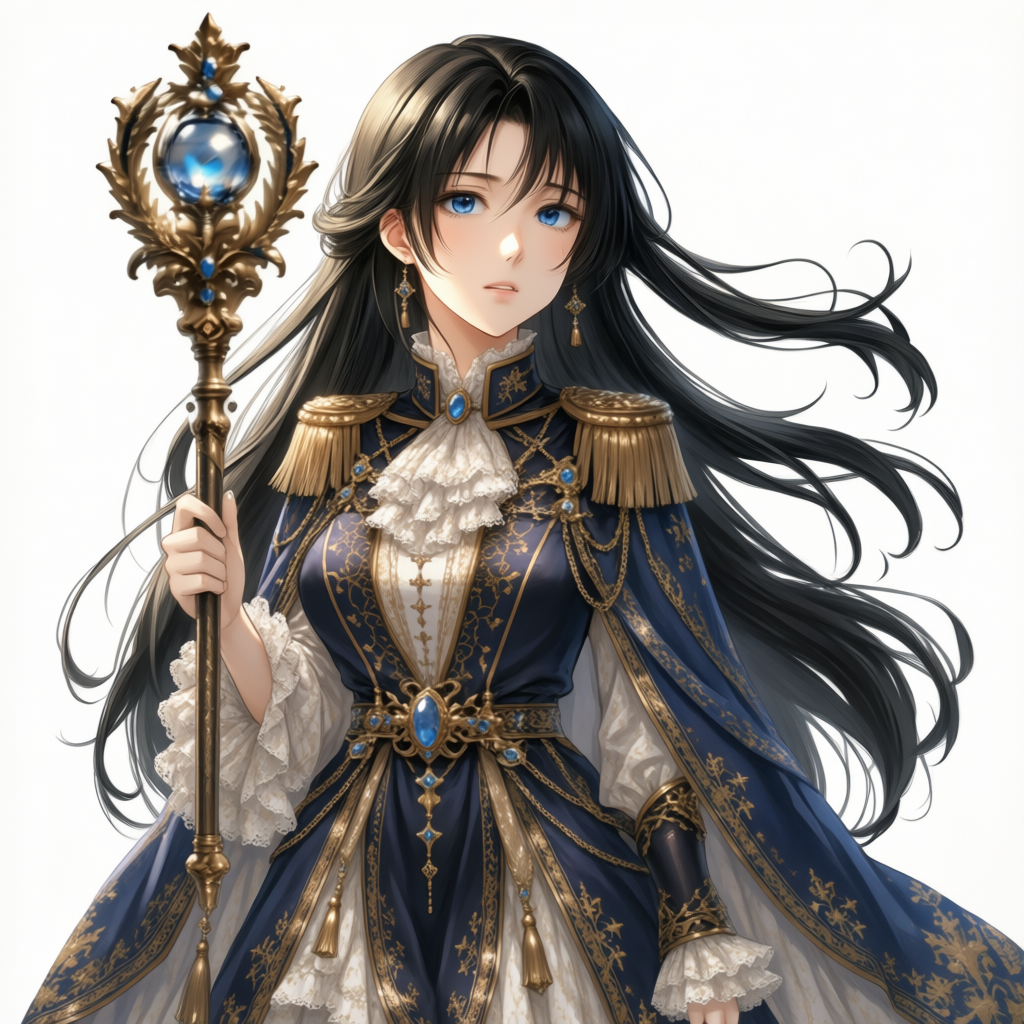
衣装と指揮棒は別画像(image2として「FireRed-Image-Edit-1.1-transformer」に追加)を参照させて変更しています。背景は、後ほど最終版に差し替えです。そして、仕上げに、UpscalerとSharpenをかければKarenの4k高精細画像が出来ります。今のところ、この手順が一番Karenのイメージに近い画像に仕上がります。AIは、見えている部分の細部に異様なこだわりがある反面、見えていない部分で手抜きをするようです。この絵の場合、左手は崩れているようですが隠れているのでギリ、セーフ。髪の毛の背面が白くなるのも手抜きのせいかなと疑っています。
ワークフローのParameterやPromptの最適化はこれからです。この最適化がトライアンドエラーで一番時間(人的リソース)がかかります。
これは、試しに別画像を「LTX-2.5_i2v」のワークフローで動画化したものです。「BiRefNet Remove Background」で背景を透明にして、背景画像をGIMPで手動合成したものを動画化しました。「Image Composite Masked」を使用して背景を合成することも可能です。

コメントを残す